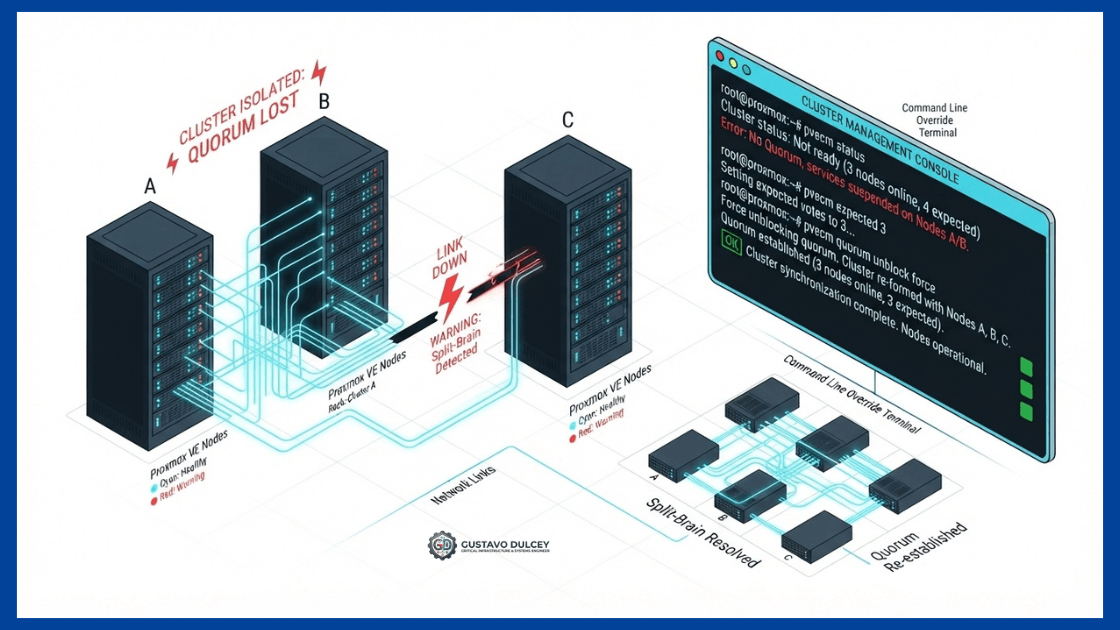
Pocos incidentes generan tanto pánico en un centro de datos como acceder a la consola web de Proxmox VE y encontrarse con el banner rojo: Error 500: cluster not ready - no quorum?, impidiendo iniciar, detener, migrar o editar cualquier máquina virtual.
Este bloqueo de emergencia no se debe a que tus discos hayan fallado ni a que el hipervisor KVM esté roto. Es un mecanismo de protección intencional del motor Corosync y del sistema de archivos distribuido de Proxmox (pmxcfs). Cuando un clúster pierde la mayoría absoluta de votos requerida para operar (quórum), el directorio de configuración /etc/pve/ se monta automáticamente en modo de solo lectura para evitar el peor escenario en virtualización: una división de red con escrituras concurrentes incompatibles (Split-Brain).
// EJECUCIÓN RÁPIDA (TL;DR) – DESBLOQUEO INMEDIATO EN 10 SEGUNDOS
# 1. Accede por SSH o consola física al nodo superviviente como root:
pvecm expected 1
# 2. Reiniciar el demonio del sistema de archivos del cluster:
systemctl restart pve-cluster
El quórum se forzará al instante. El directorio /etc/pve volverá a modo lectura/escritura y la interfaz web web recuperará el control sin reiniciar el servidor físico ni las VMs.
¿Cómo Funciona la Matemática del Quórum en Proxmox?
Para entender por qué se produjo el bloqueo, debemos revisar la fórmula matemática que rige a Corosync:
Fórmula de Quórum:Votos Necesarios = (Nodos Totales / 2) + 1
Veamos qué ocurre en los escenarios más habituales de laboratorio y producción:
- Clúster de 3 Nodos: Se requieren
(3 / 2) + 1 = 2 votos. Si un nodo cae, los 2 restantes suman mayoría y el clúster sigue funcionando de forma transparente. - Clúster de 2 Nodos (El error más común): Se requieren
(2 / 2) + 1 = 2 votos. Si un nodo se apaga o pierde el cable de red, el nodo superviviente solo tiene 1 voto de los 2 requeridos: el clúster colapsa por pérdida de quórum. - Aislamiento de Red: Si un switch falla y separa los nodos, ninguno alcanza la mayoría y todos entran en modo de autoprotección bloqueando el panel web.
Paso a Paso: Diagnóstico del Estado de Corosync
Antes de aplicar soluciones definitivas, analiza el estado actual del clúster ejecutando en la consola Shell del nodo:
pvecm statusPresta especial atención a estos tres parámetros en la salida:
Activity blocked: Yes— Confirma quepmxcfsha bloqueado las escrituras.Nodes: X— Cantidad de nodos que se detectan entre sí en la red.Expected votes: Y— Votos que el sistema espera para considerar la red segura.
Para verificar si el tráfico multicast/unicast de Corosync está llegando a través de la tarjeta de red asignada:
corosync-cfgtool -sMétodo 2: Recuperación Permanente en Clústeres de 2 Nodos (Configurar QDevice)
Si operas un entorno de alta disponibilidad con solo dos servidores físicos (desplegados por ejemplo tras completar nuestra Guía Maestra de migración desde VMware), forzar pvecm expected 1 es solo un parche temporal, ya que el ajuste se restablece al reiniciar.
La solución arquitectónica correcta es añadir un QDevice (Quorum Device): un servicio ultraligero que corre sobre una Raspberry Pi, un NAS o una pequeña máquina virtual externa, aportando el tercer voto impar de desempate.
Paso 1: Instalar dependencias en el nodo Proxmox
apt update && apt install corosync-qdevice -yPaso 2: Inicializar el dispositivo externo
En el servidor externo (por ejemplo, una máquina Debian/Ubuntu en tu red o en un contenedor vinculado a tu almacenamiento en red de Synology), instala el demonio de voto:
apt install corosync-qnetd -yPaso 3: Vincular el QDevice desde Proxmox
Desde el nodo maestro de Proxmox, enlaza el dispositivo indicando su dirección IP:
pvecm qdevice setup 192.168.1.200A partir de este momento, el clúster tendrá 3 votos totales (Nodo 1 + Nodo 2 + QDevice). Si cualquiera de los dos servidores Proxmox se apaga por mantenimiento, el nodo restante formará mayoría con el QDevice (2 de 3 votos) y el clúster nunca volverá a caer en bloqueo de quórum.
Método 3: Eliminación Forzada de un Nodo Muerto del Clúster
Si uno de los servidores físicos sufrió una avería catastrófica de hardware (placa base o CPU quemada) y no volverá a encenderse, debes eliminarlo formalmente del árbol para que los nodos supervivientes reajusten el quórum de forma permanente.
¡PRECAUCIÓN DE SEGURIDAD!
Nunca vuelvas a encender ni conectar a la red un nodo que haya sido eliminado del clúster mediante este método mientras conserve su configuración antigua, o provocará una corrupción inmediata del archivo de clúster.
- Fuerza temporalmente el quórum en el nodo activo:
pvecm expected 1 - Identifica el nombre exacto del nodo defectuoso:
pvecm nodes - Ejecuta la eliminación del nodo:
pvecm delnode pve-nodo-muerto - Limpia los archivos de configuración huérfanos que hayan quedado en el árbol:
rm -rf /etc/pve/nodes/pve-nodo-muerto
Protocolo Post-Recuperación de Máquinas Virtuales
Una vez recuperado el acceso a la interfaz web, el hipervisor reanudará las tareas programadas. Es el momento idóneo para:
- Verificar que las máquinas virtuales Windows arranquen sin bloqueos de disco (en caso de fallos tras migraciones abruptas, aplica nuestra guía para resolver el pantallazo azul Inaccessible Boot Device).
- Auditar el espacio en los datastores y proceder a compactar los discos QCOW2 para liberar ancho de banda en la red de sincronización.
Preguntas Frecuentes
¿Por qué no puedo editar corosync.conf directamente con nano?
El archivo /etc/pve/corosync.conf reside en pmxcfs. Cuando no hay quórum, el sistema rechaza cualquier intento de escritura con el mensaje Read-only file system. Si requieres editarlo en modo rescate, debes detener temporalmente los servicios y arrancar el sistema de archivos en modo local ejecutando: systemctl stop pve-cluster corosync && pmxcfs -l.
¿Las máquinas virtuales se apagan solas cuando se pierde el quórum?
No. Las VMs que ya estaban en ejecución continúan funcionando en la memoria RAM y procesador del host. Lo que queda bloqueado es el plano de control (la API, la interfaz web, la capacidad de encender nuevas máquinas o ejecutar snapshots).
Manual técnico de infraestructura y alta disponibilidad validado por Gustavo Dulcey, Ingeniero de Sistemas especializado en Arquitecturas de Virtualización Resilientes.