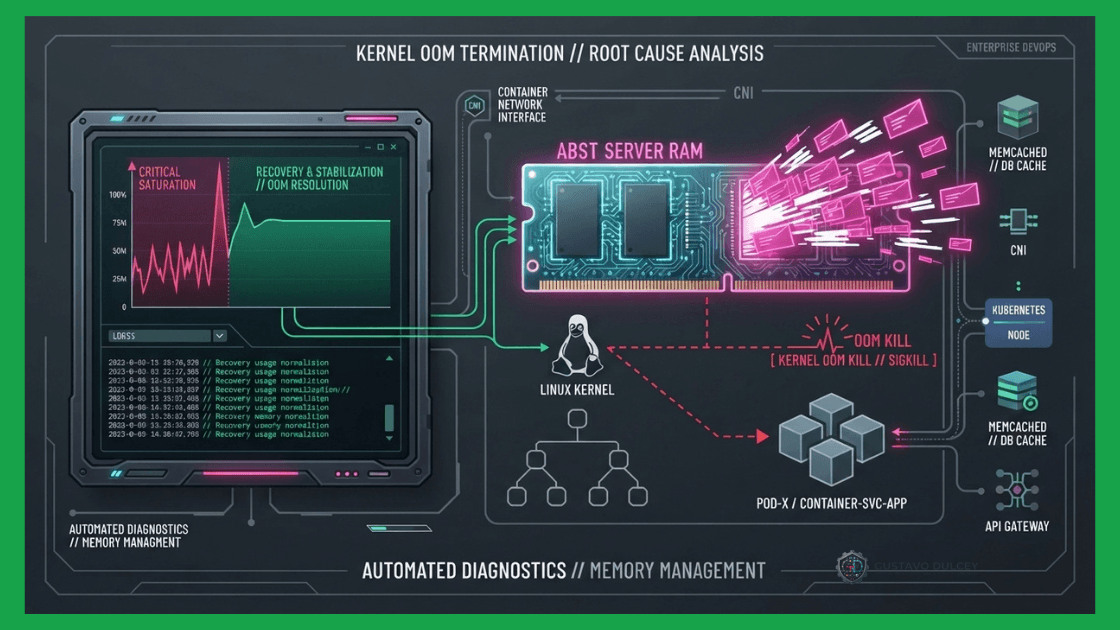
El código de terminación Exit Code 137 acompañado del estado OOMKilled es uno de los fallos más destructivos en entornos de producción: detiene procesos sin previo aviso, corrompe transacciones en memoria y desencadena bucles de reinicio masivos en clústeres.
En el estándar POSIX de Linux, el código de salida 137 tiene una explicación matemática precisa: 128 + 9 (SIGKILL). Significa que el proceso principal del contenedor no se detuvo voluntariamente, sino que fue aniquilado de forma forzada por una señal kill -9 emitida directamente por el kernel del sistema operativo. Comprender si este sacrificio fue ordenado por el mecanismo OOM-Killer (Out of Memory Killer) o por un timeout del orquestador es el primer paso para estabilizar tu infraestructura, especialmente si tus servicios operan detrás de nuestra arquitectura de Reverse Proxy NGINX con Docker y SSL.
// EJECUCIÓN RÁPIDA (TL;DR) – CONFIRMAR OOMKILLED EN 5 SEGUNDOS
# En Docker (Inspección directa de metadatos de cgroups):
docker inspect mi-contenedor --format 'ExitCode: {{.State.ExitCode}} | OOMKilled: {{.State.OOMKilled}}'
# En Kubernetes (Ver la causa exacta de la muerte anterior):
kubectl get pod mi-pod -o jsonpath='{.status.containerStatuses[*].lastState.terminated.reason}'
Si retorna “OOMKilled”, el proceso superó el límite de memoria asignado en el YAML o agotó la memoria RAM física del host.
La Diferencia Crítica: ¿OOMKilled o SIGKILL Externo?
No todos los Exit Code 137 son causados por falta de memoria. El kernel asigna 137 a cualquier proceso terminado mediante SIGKILL. Existen dos escenarios radicalmente distintos:
- Escenario A: OOMKilled = True: El contenedor superó la cuota de memoria RAM establecida en su directiva
limits.memory(en Kubernetes) o--memory(en Docker). El kernel de Linux aplicó el límite de cgroups y liquidó el proceso de forma fulminante. - Escenario B: OOMKilled = False (Falso positivo de memoria): El orquestador envió una señal de apagado ordenado
SIGTERM(por ejemplo, durante un despliegue o escalado), pero la aplicación no cerró sus conexiones en el tiempo de gracia permitido (30 segundos por defecto). Al cumplirse el plazo, Kubernetes o Docker enviaron unSIGKILLforzado, registrando el código 137 sin que existiera ningún problema de memoria.
1. Diagnóstico Forense en el Kernel de Linux
Para confirmar el momento exacto en que el kernel intervino, consulta el buffer de mensajes del sistema en el nodo de trabajo físico (Worker Node):
dmesg -T | grep -E -i "oom_reaper|killed process"La salida revelará la línea forense definitiva:
[Mon Sep 28 14:22:01 2026] Memory cgroup out of memory: Killed process 41829 (node) total-vm:2451200kB, anon-rss:1048576kB, file-rss:128kB, shmem-rss:0kB, UID:1000 pgtables:4800kB oom_score_adj:998Este registro confirma que el proceso (en este caso Node.js) alcanzó su techo asignado de memoria anónima (anon-rss) y fue sacrificado por el sistema.
2. Solución en Entornos Docker y Docker Compose
En Docker, un contenedor sin límites explícitos puede devorar toda la memoria RAM del servidor host hasta congelar el sistema operativo. La solución consiste en fijar límites estrictos y reservar memoria base:
services:
  mi-servicio:
    image: mi-app:latest
    container_name: mi-servicio
    deploy:
      resources:
        limits:
          cpus: '2.0'
          memory: 2048M   # Límite máximo: si lo supera, se activa OOM-Killer
        reservations:
          cpus: '0.5'
          memory: 512M    # Memoria garantizada para el contenedor
3. Solución en Kubernetes: Ajuste de Requests, Limits y Clases QoS
En Kubernetes, un contenedor que muere por OOMKilled suele provocar que el pod caiga en un bucle destructivo. Para corregir la cascada de fallos asociada, revisa los pasos de nuestra guía para solucionar el estado CrashLoopBackOff en Kubernetes.
La Trampa de los Límites Simétricos y las Clases QoS
Kubernetes clasifica los pods en tres niveles de calidad de servicio (QoS):
- Guaranteed (Garantizado):
requests.memoryes exactamente igual alimits.memory. Es la configuración recomendada para bases de datos y servicios críticos; son los últimos en ser sacrificados si el nodo entra en presión de memoria. - Burstable: El límite es superior a la petición base (ej. request: 512Mi, limit: 2Gi). Permite absorber picos temporales.
- BestEffort: No define límites ni peticiones. Son los primeros procesos que el kernel ejecutará en caso de saturación.
Configuración óptima para un microservicio productivo:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api-backend
spec:
  template:
    spec:
      containers:
      - name: api
        image: api:v2
        resources:
          requests:
            memory: "1Gi"
            cpu: "500m"
          limits:
            memory: "2Gi"
            cpu: "1000m"
4. Las 2 Causas Ocultas en Runtimes de Software
Causa A: La Trampa de la JVM de Java en Contenedores
Las aplicaciones desarrolladas en Java son las mayores víctimas del error OOMKilled. En versiones antiguas de Java (anteriores a Java 11.0.16 o Java 8u191), la máquina virtual no reconoce los límites de memoria impuestos por cgroups; consulta la memoria total del servidor físico y calcula su memoria dinámica (Heap) en función de ese valor. Si el host tiene 64 GB de RAM pero el contenedor tiene un límite de 2 GB, la JVM intentará asignar un Heap de 16 GB, siendo aniquilada al instante por el kernel.
Solución: Pasa los siguientes parámetros al comando de arranque de tu contenedor Java:
java -XX:+UseContainerSupport -XX:MaxRAMPercentage=75.0 -jar app.jarEsto restringe el tamaño del Heap a un 75% del límite real del cgroup, reservando el 25% restante para memoria nativa y el hilo de recolección de basura.
Causa B: Fugas de Memoria en Node.js (V8 Garbage Collector)
Por defecto, el motor V8 de Node.js limita el uso de memoria a ~1.4 GB en arquitecturas de 64 bits. Si tu contenedor tiene 4 GB disponibles pero Node.js no libera objetos retenidos en el Event Loop, alcanzará el tope del runtime y abortará con código 137.
Ajusta el flag de memoria en el script de inicio:
node --max-old-space-size=3072 index.jsImpacto en la Red y Servicios Upstream
Cuando un microservicio muere abruptamente por un evento OOMKilled, las conexiones HTTP en curso se cierran sin enviar cabeceras TCP de finalización (FIN/RST). Como consecuencia inmediata, el proxy inverso no recibe respuesta en el socket de red y devuelve un error de pasarela hacia los clientes externos. Si estás experimentando este síntoma colateral, revisa los métodos de diagnóstico en nuestra guía para solucionar el error NGINX 502 Bad Gateway con Docker Proxy Pass.
Asimismo, si alojas tus nodos de contenedores sobre máquinas virtuales, verifica que el hipervisor subyacente no esté sobreasignando memoria RAM física mediante ballooning, siguiendo las recomendaciones de nuestra Guía de virtualización y dimensionamiento en Proxmox VE.
Preguntas Frecuentes
¿Aumentar la memoria Swap en el host soluciona el error OOMKilled?
No es una solución recomendada en producción. Habilitar Swap evita que el proceso sea terminado por el OOM-Killer de inmediato, pero provoca una degradación extrema del rendimiento de I/O en disco (thrashing). En contenedores, es preferible que un proceso falle rápido (fail-fast) y se reinicie de forma limpia antes de degradar la latencia de todo el servidor.
¿Qué diferencia hay entre Exit Code 137 y Exit Code 143?
Exit Code 143 corresponde a 128 + 15 (SIGTERM). Indica que el contenedor recibió una orden de parada estándar y tuvo el tiempo necesario para cerrar sockets, vaciar buffers y apagarse de forma limpia y ordenada. Exit Code 137 es siempre una terminación forzada (violenta).
Manual técnico de infraestructura y optimización de recursos elaborado por Gustavo Dulcey, Ingeniero de Sistemas especializado en Arquitecturas Cloud Native y Rendimiento de Kernel Linux.