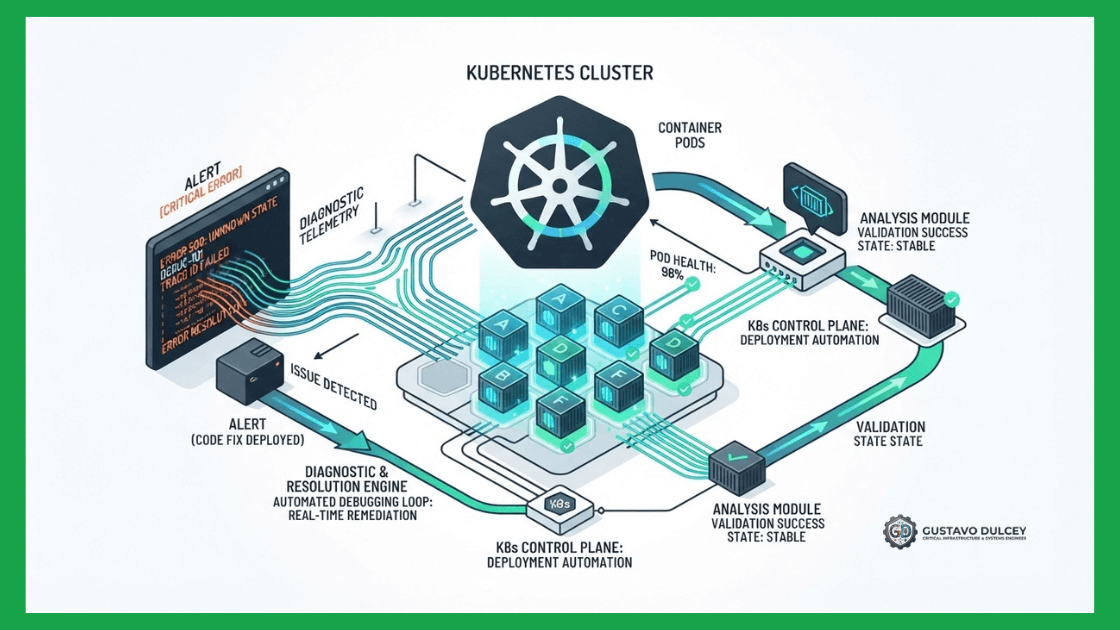
Ver un pod en estado CrashLoopBackOff al ejecutar kubectl get pods es uno de los escenarios más habituales y frustrantes en la administración de clústeres de Kubernetes.
Lo primero que debe comprender un ingeniero de sistemas es que CrashLoopBackOff no es un error en sí mismo, sino un estado transitorio del plano de control de Kubernetes (Kubelet). Indica que el contenedor dentro del pod se inició, falló de forma inmediata o abortó su ejecución, y Kubernetes lo reinició repetidamente hasta entrar en una penalización de espera exponencial (Back-Off delay: 10s, 20s, 40s hasta un tope de 5 minutos) para evitar la saturación de CPU y memoria en el nodo de trabajo. Si gestionas estos despliegues tras un balanceador central, puedes conectarlo con nuestra Guía de Reverse Proxy NGINX con Docker y SSL.
// EJECUCIÓN RÁPIDA (TL;DR) – COMANDOS DE DIAGNÓSTICO EN 3 PASOS
# 1. Ver el log del fallo JUSTO ANTES del último reinicio (Clave absoluta):
kubectl logs nombre-del-pod --previous
# 2. Inspeccionar el código de salida (Exit Code) y los eventos del ciclo de vida:
kubectl describe pod nombre-del-pod
# 3. Regla rápida de interpretación del Exit Code:- Exit Code 1: Error en la aplicación o variable de entorno faltante.
– Exit Code 137: Contenedor eliminado por el kernel OOMKilled (falta de RAM).
– Exit Code 139: Segmentation Fault (fallo en binario o biblioteca C compartida).
1. El Flujo de Trabajo para Aislar la Causa Raíz
No reinicies el despliegue ni borres el pod; hacerlo elimina el historial forense de ejecución. Sigue este orden estricto de depuración en la terminal:
Paso 1: Leer el buffer de terminación (–previous)
Cuando ejecutas kubectl logs mi-pod en un contenedor atascado en bucle, habitualmente recibes una salida vacía porque el contenedor actual apenas está arrancando o esperando el temporizador de back-off. El parámetro --previous obliga al API Server a consultar el registro del proceso que murió en la iteración anterior:
kubectl logs mi-pod-xyz -c contenedor-afectado --previousEn el 75% de los casos, este comando devuelve la excepción exacta de la aplicación (ejemplo: Database connection string missing, Port 8080 already in use o SyntaxError in index.js).
Paso 2: Inspeccionar la sección “Last State” con ‘kubectl describe’
Ejecuta la descripción completa del recurso:
kubectl describe pod mi-pod-xyzBaja hasta el bloque Containers: > State: > Last State: y revisa:
- Reason: Error — La aplicación terminó con un código de retorno distinto de cero.
- Reason: OOMKilled — El contenedor superó el límite de memoria asignado por cgroups. En este caso, consulta de inmediato nuestra guía para diagnosticar y corregir el error OOMKilled (Exit Code 137).
- Events: Al final de la salida, revisa si Kubelet reporta fallos en las sondas de salud (Unhealthy: Liveness probe failed).
2. Las 3 Causas Más Comunes y sus Soluciones
Causa A: ConfigMaps o Secretos Mal Mapeados
Si tu aplicación requiere variables de entorno obligatorias cargadas desde un ConfigMap o Secret que no existe en el namespace, el pod intentará arrancar, fallará la validación en código y morirá de inmediato.
Cómo detectarlo: En los eventos de kubectl describe pod verás:
Warning FailedMount MountVolume.SetUp failed for volume "app-secrets" : secret "api-keys" not foundSolución: Verifica que los recursos existan en el mismo namespace exacto antes de lanzar el manifiesto:
kubectl get configmap,secret -n mi-namespaceCausa B: Sonda de Vida (Liveness Probe) Demasiado Agresiva
Las sondas livenessProbe verifican periódicamente si el proceso responde (por ejemplo, enviando una petición HTTP GET a /healthz). Si la aplicación tarda 45 segundos en inicializar bases de datos y tu sonda empieza a consultar a los 10 segundos, Kubelet asume que el contenedor está colgado y lo mata, generando un bucle CrashLoopBackOff infinito.
Solución: Ajusta el parámetro initialDelaySeconds o implementa una startupProbe dedicada en tu manifiesto Deployment:
livenessProbe:
  httpGet:
    path: /healthz
    port: 8080
  initialDelaySeconds: 60   # Dar 60s de margen para inicialización
  periodSeconds: 10
  failureThreshold: 3
Causa C: El Proceso Principal (PID 1) Termina Inmediatamente
Un contenedor de Docker o Kubernetes solo vive mientras el proceso principal (definido en CMD o ENTRYPOINT) continúe ejecutándose en primer plano (foreground). Si utilizas un script de bash que lanza un demonio en segundo plano (como service nginx start) y termina, el contenedor finaliza con Exit Code 0, pero Kubernetes lo considera un fallo si la directiva de reinicio es RestartPolicy: Always.
Solución: Asegúrate de que el proceso corra en primer plano en el manifiesto:
command: ["nginx", "-g", "daemon off;"]3. Depuración Avanzada mediante Sobreescritura del Comando (Debug Mode)
Si la aplicación se cierra tan rápido que no alcanzas a capturar los registros con --previous, puedes forzar al contenedor a mantenerse con vida ejecutando un bucle infinito de espera para acceder por shell interactiva:
- Edita el despliegue con
kubectl edit deployment mi-app. - Sobreescribe temporalmente el
commanden el bloque del contenedor:command: ["/bin/sh", "-c", "sleep 3600"] - Aplica los cambios. El pod entrará en estado
Running. - Accede al contenedor para depurar manualmente:
kubectl exec -it mi-pod-xyz -- /bin/sh - Ejecuta el binario original a mano (ejemplo:
node server.jsopython main.py) y observa la traza del error en pantalla.
Integración con la Arquitectura de Microservicios
Recuerda que un pod en CrashLoopBackOff nunca pasará la sonda readinessProbe, lo que significa que el Servicio (Service) de Kubernetes lo retirará de los endpoints de balanceo. Si el proxy inverso que atiende las peticiones externas no encuentra endpoints activos en el upstream, devolverá un error de puerta de enlace. Puedes revisar cómo aislar este comportamiento en nuestra guía para solucionar el error NGINX 502 Bad Gateway con Docker Proxy Pass.
Asimismo, si tus nodos de Kubernetes están alojados sobre hipervisores virtualizados, audita la estabilidad de las tarjetas de red virtuales siguiendo las pautas de nuestra Guía de virtualización empresarial en Proxmox.
Preguntas Frecuentes
¿Cómo forzar el reinicio inmediato de un pod atascado en back-off sin esperar los 5 minutos?
El comando más rápido para limpiar el temporizador de penalización es reiniciar el deployment de forma controlada:
kubectl rollout restart deployment mi-despliegue¿Un fallo en los permisos de un volumen persistente (PVC) puede causar CrashLoopBackOff?
Sí. Si la aplicación intenta escribir en un directorio montado (por ejemplo, /var/log/ o /data/) y el usuario sin privilegios del contenedor no tiene permisos POSIX de escritura (UID/GID), el proceso lanzará un error EACCES: permission denied y se detendrá inmediatamente.
Manual técnico de operaciones Kubernetes elaborado y validado por Gustavo Dulcey, Ingeniero de Sistemas especializado en Orquestación Cloud Native y DevOps.